Коротко: что нужно и сколько это стоит
Свой ИИ-агент — это языковая модель, которой дали инструменты: она не только отвечает, но и сама решает, что сделать, — посчитать, найти в базе, отправить запрос в CRM. Собрать такого агента можно в n8n без программирования: у разработчика есть готовая сборка Self-hosted AI Starter Kit, где n8n, Ollama для своей модели, векторная база Qdrant и PostgreSQL ставятся одной командой Docker. Программы бесплатны, а со своей моделью платите только за сервер. Под небольшую модель на процессоре берите 8 ГБ памяти — у AdminVPS это Start за 1 289 ₽/мес при оплате за месяц. Модели крупнее нужна видеокарта, и с ней сейчас сложнее: у AdminVPS прайс от 7 749 ₽/мес, но на 7 ноября 2026 года и эта карта, и A4000 с A5000 «нет в наличии» — что можно купить, в разделе о сервере.
Такого агента называют локальным: модель работает на вашем сервере, и запросы с данными никуда не уходят. Если модель брать по API у поставщика, сервер нужен слабее, но запросы уходят поставщику, а за токены платите по его тарифу.
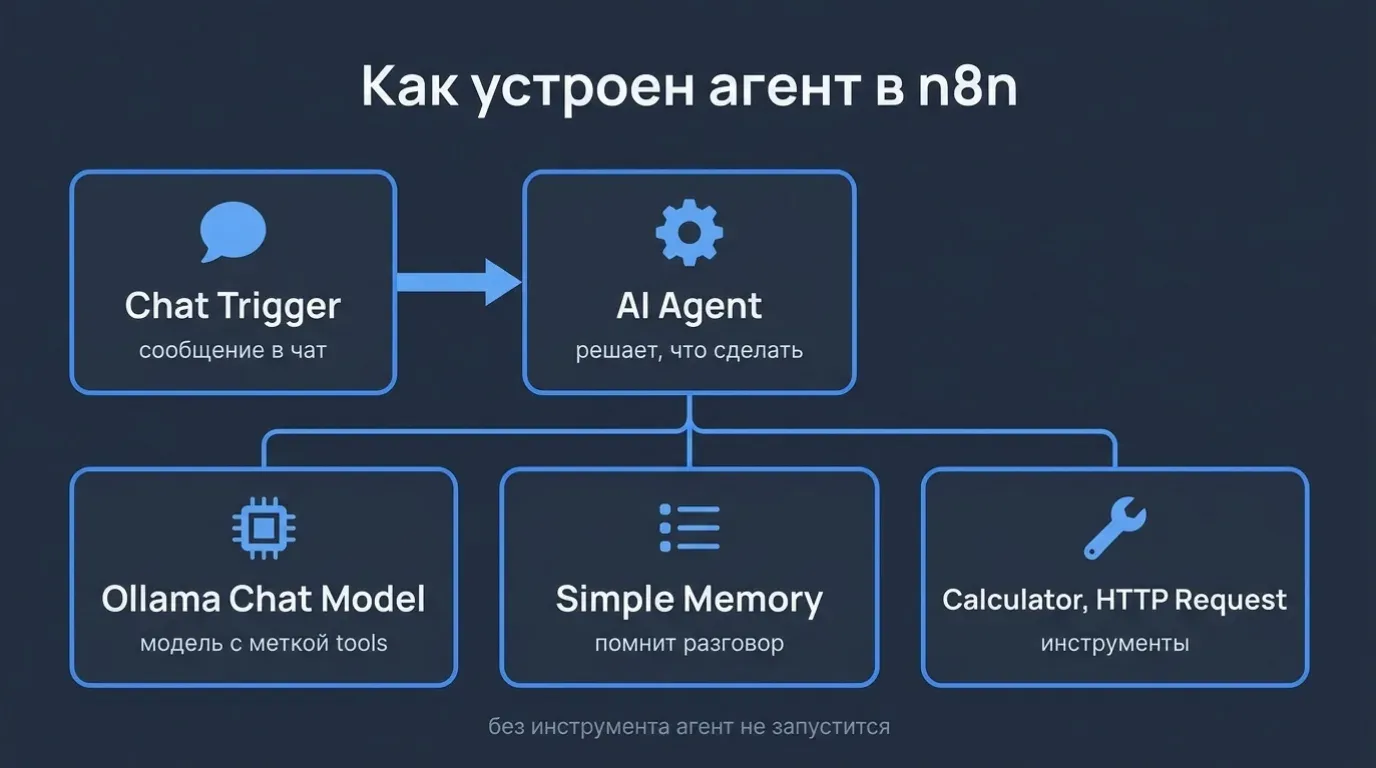
Из чего состоит агент в n8n
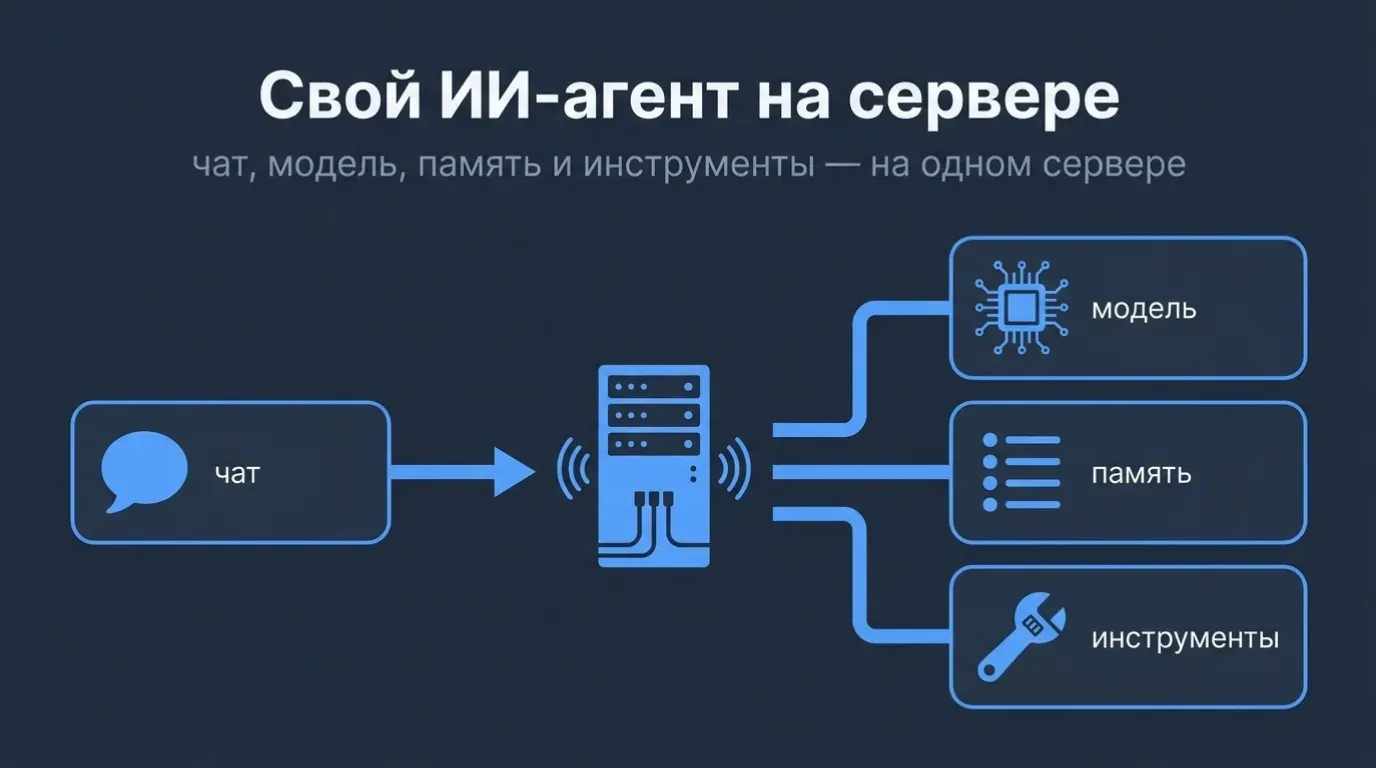
Документация n8n определяет агента как автономную систему, которая получает данные, принимает решения и действует, чтобы добиться цели. В редакторе n8n он собирается из узлов, как из деталей:
- Chat Trigger — вход: окно чата, через которое агенту пишут.
- AI Agent — сам агент. С версии n8n 1.82 у него один режим, Tools Agent.
- Модель — узел Ollama Chat Model, если модель своя. Похожий узел Ollama Model к агенту не подключается: по документации n8n у него нет поддержки инструментов.
- Память — Simple Memory: агент помнит последние сообщения разговора.
- Инструменты — хотя бы один обязателен, без него агент не запустится. Самый простой — Calculator. Настоящие — запрос к API вашей CRM через HTTP Request, таблица, почта, база данных.
Модель тоже годится не любая. Агент вызывает инструменты, и модель должна это уметь: в библиотеке Ollama у таких моделей стоит метка tools. Она есть у llama3.2 и у qwen3.
Своя модель или модель по API
Если агенту нужно только отвечать клиентам по вашим ценам и условиям, а не действовать в ваших системах, сервер можно не арендовать вовсе. Как собрать такого консультанта на платформе AI-агентов Timeweb Cloud, во что обходится тысяча ответов и когда нужна база знаний, разобрано в статье об ИИ-агенте для бизнеса.
Главный выбор делается до покупки сервера.
Своя модель через Ollama. Запросы обрабатываются на вашем сервере и не покидают его, токены не оплачиваются. Зато серверу нужна память под файл модели, а для моделей крупнее — видеокарта. Файлы моделей по библиотеке Ollama: llama3.2 — 2,0 ГБ, qwen3:4b — 2,5 ГБ, qwen3:8b — 5,2 ГБ, qwen3:14b — 9,3 ГБ. Подробно о том, сколько памяти нужно модели и как проверить, что она работает на видеокарте, — в руководстве по Ollama.
Модель по API. n8n подключает модели поставщиков своими узлами, и тогда серверу хватает ресурсов обычной n8n. Но запросы с вашими данными уходят поставщику, а за токены вы платите по его тарифу. Прежде чем выбрать поставщика, проверьте две вещи: работает ли он с Россией и есть ли для него узел в n8n.
Какой сервер нужен
Под саму n8n с помощником документация n8n просит от 4 ГБ RAM и 2 vCPU. Дальше считайте от модели: её файл плюс n8n, база и Qdrant должны помещаться в память с запасом. Все цены в списке — при оплате за месяц; у AdminVPS сверены по странице провайдера 24–27 сентября 2026 года, у Timeweb Cloud — 23 октября 2026 года, после подорожания.
- Модель по API — хватает 4 ГБ. AdminVPS Micro — 2 ядра 3,6 ГГц, 4 ГБ, 60 ГБ NVMe: 899 ₽/мес. Timeweb Cloud, тариф Cloud MSK 50 — 2 ядра, 4 ГБ, 50 ГБ NVMe: 3 840 ₽/мес.
- Своя небольшая модель на процессоре (llama3.2, qwen3:4b) — 8 ГБ. AdminVPS Start — 4 ядра 3,6 ГГц, 8 ГБ, 80 ГБ NVMe: 1 289 ₽/мес. Timeweb Cloud, тариф Cloud MSK 80 — 4 ядра, 8 ГБ, 80 ГБ NVMe: 7 000 ₽/мес.
- qwen3:8b на процессоре — 12 ГБ. AdminVPS Standart — 8 ядер, 12 ГБ, 100 ГБ NVMe: 2 149 ₽/мес. Timeweb Cloud, тариф Cloud MSK 100 — 8 ядер, 12 ГБ, 100 ГБ NVMe: 10 760 ₽/мес.
- Модель крупнее, на видеокарте. У AdminVPS GTX 1080 Ti с 11 ГБ видеопамяти — 7 749 ₽/мес (Исландия); в России RTX A4000 с 16 ГБ — 10 959 ₽/мес и RTX A5000 с 24 ГБ — 17 709 ₽/мес. У GPU-тарифов AdminVPS есть готовый шаблон Self-hosted LLM (Ollama). Но 21 октября 2026 года корзина AdminVPS по всем GPU-тарифам отвечала «нет в наличии», и 7 ноября по GTX 1080 Ti, A4000 и A5000 ответ тот же. У Timeweb Cloud готовый выделенный сервер с Tesla T4 на 16 ГБ — 16 800 ₽/мес, на странице выделенных серверов за кнопкой «Показать ещё»; почасовой оплаты у GPU нет. Сравнение карт — в обзоре GPU-серверов.
На процессоре модель отвечает медленнее, чем на видеокарте: в нашей проверке на 4 vCPU llama3.2 писала 5,7–5,9 токена в секунду, qwen3:4b — 4,5–4,6 (подробности — в разделе о проверке ниже). Если агент работает с персональными данными россиян, которые по статье 18 152-ФЗ нужно хранить в России, берите сервер в России: тарифы VPS выше у обоих провайдеров — российские площадки, а из видеокарт AdminVPS в России стоят A4000 и A5000 — на 7 ноября 2026 года их нет в наличии.
Реклама · ООО «Админвпс»
AdminVPS
Start за 1 289 ₽/мес при оплате за месяц: 4 ядра 3,6 ГГц, 8 ГБ RAM, 80 ГБ NVMe — n8n и небольшая модель Ollama на одном сервере. n8n и Ollama есть в маркетплейсе AdminVPS. По промокоду EASYLINK первый месяц Start — 515,60 ₽: скидка 60 % при оплате за месяц.
Шаг 1. Поставить Docker
Сборка работает в Docker, поэтому нужны Docker и Docker Compose. Как их поставить на Ubuntu, по шагам написано в руководстве по установке n8n. Дальше все команды — на сервере.
Шаг 2. Скачать сборку и сменить пароли
Сборку выпускает сама n8n, она лежит на GitHub:
git clone https://github.com/n8n-io/self-hosted-ai-starter-kit.git
cd self-hosted-ai-starter-kit
cp .env.example .env
В файле .env стоят учебные значения: пароль базы password, ключ шифрования super-secret-key. Замените три строки — POSTGRES_PASSWORD, N8N_ENCRYPTION_KEY и N8N_USER_MANAGEMENT_JWT_SECRET — на случайные значения. Сгенерировать каждое можно командой:
openssl rand -hex 32Шаг 3. Закрыть порты
Сборка рассчитана на локальный компьютер и открывает три порта на всех адресах: 5678 у n8n, 11434 у Ollama и 6333 у Qdrant. На сервере это значит — на весь интернет. Пароля у API Ollama нет, а Qdrant, по его документации, без настройки принимает запросы от любого, кто до него достучится. Файрвол ufw не спасает: порты, которые открывает Docker, по документации Docker идут мимо его правил.
Поэтому до запуска привяжите все три порта к 127.0.0.1:
sed -i 's/- 5678:5678/- 127.0.0.1:5678:5678/; s/- 11434:11434/- 127.0.0.1:11434:11434/; s/- 6333:6333/- 127.0.0.1:6333:6333/' docker-compose.yml
grep -n "127.0.0.1" docker-compose.yml
Вторая команда должна показать три строки. Меньше — какой-то порт остался открытым.
Шаг 4. Запустить и открыть редактор
На сервере без видеокарты:
docker compose --profile cpu up -dНа сервере с видеокартой NVIDIA — docker compose --profile gpu-nvidia up -d; если Docker там ещё не работал с видеокартой, сперва настройте её по инструкции Ollama для Docker, на которую ссылается сборка. Сборка сама скачает модель llama3.2; как идёт загрузка, видно командой docker logs -f ollama-pull-llama.
Редактор n8n теперь слушает только сам сервер. Откройте его со своего компьютера через туннель SSH:
ssh -L 5678:127.0.0.1:5678 user@АДРЕС_СЕРВЕРАПока туннель открыт, редактор доступен в браузере по адресу http://localhost:5678. При первом входе n8n попросит завести учётную запись владельца.
Llama3.2 инструменты вызывает, но модель маленькая. Если памяти хватает, скачайте qwen3:4b или qwen3:8b:
docker exec -it ollama ollama pull qwen3:4bШаг 5. Собрать агента
В редакторе создайте новый сценарий и соберите цепочку:
- Добавьте узел Chat Trigger, за ним — AI Agent.
- К агенту в гнездо Chat Model подключите Ollama Chat Model. В сборке лежат учётные данные Local Ollama service, но в нашей проверке до n8n они не дошли: сборка пропустила импорт (почему — в разделе о проверке ниже). Создайте свои — тип Ollama, Base URL
http://ollama:11434. В поле модели укажитеqwen3:4bилиllama3.2. - В гнездо Memory подключите Simple Memory.
- В гнездо Tool подключите Calculator — это минимальный инструмент, с ним агент уже работает.
Откройте чат внизу редактора и спросите: «Сколько будет 17 % от 2 350?» Агент должен вызвать калькулятор, а не считать сам — это видно в журнале выполнения. Сверьте и само число: верный ответ — 399,5. В нашей проверке llama3.2 вызывала калькулятор с выражением, которого он не понимает, и всё равно называла неверное число; qwen3:4b считала верно, но долго.
Роль и правила агента задаются в параметре System Message узла AI Agent: кто он, что ему можно и когда он должен ответить «не знаю». Дальше заменяйте калькулятор настоящими инструментами. Документация n8n показывает это на примере «Call APIs»: агент вызывает отдельный сценарий-инструмент, а тот через узел HTTP Request забирает данные из внешнего API.
Что ломается
- Узел Ollama Model вместо Ollama Chat Model. Первый не поддерживает инструменты и к агенту не подключится.
- Модель без метки tools. Агент не сможет вызвать инструмент. Сверяйтесь с меткой модели в библиотеке Ollama.
- n8n не видит Ollama. Адрес
localhostвнутри контейнера n8n ведёт в сам контейнер n8n. В этой сборке Ollama живёт в контейнереollama, адрес —http://ollama:11434. - Модель не помещается в память. Проверка —
docker exec -it ollama ollama ps: колонка PROCESSOR покажет, где работает модель. Не хватает памяти — берите модель меньше или сервер больше. - Маленькая модель путается в инструментах — может не вызвать нужный, вызвать не тот или передать ему выражение, которое инструмент не понимает, и назвать неверное число: так было в нашей проверке с llama3.2. Проверяйте агента на своих задачах, прежде чем отдавать ему работу.
- Сборка — не боевая установка. Сама n8n пишет, что сборка не доведена для рабочей среды и подходит для проб. Для постоянной работы добавьте домен с HTTPS и резервные копии — оба шага есть в руководстве по n8n.
Проверка на сервере 21.10.2026: что вышло по шагам
21.10.2026 мы прошли команды этой статьи на чистом сервере Timeweb Cloud с Ubuntu 24.04: тариф Cloud NSK 80 — 4 vCPU, 8 ГБ памяти, 80 ГБ NVMe, та же конфигурация, что Cloud MSK 80 (в Москве в тот вечер свободного места под тариф не нашлось). Наш замер 21.10 — разовый, без видеокарты; сервер удалён после проверки.
- Шаги 1–4 работают дословно. Установка Docker 29.9.2 по документации Docker заняла 49 секунд. Сборка — версия 662bd88 от 23.07.2026, учебные значения в .env те, что названы выше; правка портов дала три строки с 127.0.0.1. Команда docker compose --profile cpu up -d отработала за 401 секунду, модель llama3.2 докачалась через 572 секунды от запуска.
- Порты закрыты. С двух внешних адресов в разных сетях 5678, 11434 и 6333 не отвечают; SSH на том же сервере открыт.
- Учётных данных Ollama в n8n не оказалось. Сборка импортирует демо-данные, только если сценариев ещё нет, и проверяет это командой n8n list:workflow. n8n 2.44.5 печатает в тот же вывод предупреждение, что PostgreSQL 16 поддерживается только для совместимости, — проверка приняла его за сценарии, в журнале n8n-import стоит «Workflows exist, skipping import», а в базе ноль учётных данных и ноль сценариев. Созданные вручную учётные данные с адресом http://ollama:11434 заработали сразу.
- Агент из шага 5 на вопрос «Сколько будет 17 % от 2 350?» (верно — 399,5). С llama3.2 он вызывал калькулятор, но передавал ему «17 % 2350» и «17 * 2 350»: калькулятор отвечал, что не понимает выражение, а агент всё равно называл число — 391,5 и 385, за 25 и 7 секунд. С qwen3:4b — «0.17 * 2350» и верный ответ 399,50, но за 315 секунд.
- Скорость на процессоре. Через API Ollama, ответ до 300 токенов, после прогрева, по три запуска: llama3.2 — 5,7–5,9 токена в секунду, qwen3:4b — 4,5–4,6. Ответ в 300 токенов — около минуты. Ollama показала 100% CPU.
- Память. С загруженной qwen3:4b занято 5,1 ГБ из 7,9: Ollama — 4,0 ГБ, n8n — 0,4 ГБ. С двумя моделями в памяти свободным оставался около 1 ГБ — держите одну.
Чего проверка не показывает: скорость на видеокарте и на других процессорах, агента с настоящими инструментами вместо калькулятора и нагрузку от нескольких пользователей сразу.
Сколько стоит в месяц: три варианта
Программы бесплатны, деньги уходят на сервер, а в первом варианте ещё и на токены. Все цены — при оплате за месяц.
- Модель по API — сервер от 899 ₽/мес (AdminVPS Micro) плюс оплата поставщику модели по его тарифу. Данные уходят поставщику.
- Своя небольшая модель на процессоре — от 1 289 ₽/мес (AdminVPS Start). Токенов нет, данные остаются на сервере, но модель небольшая и ответы медленнее.
- Своя модель на видеокарте — сейчас купить можно у Timeweb Cloud: выделенный сервер с Tesla T4 на 16 ГБ — 16 800 ₽/мес (цена со страницы провайдера 6 ноября 2026 года). У AdminVPS прайс от 7 749 ₽/мес (GTX 1080 Ti, Исландия), но с 21 октября его GPU-тарифы «нет в наличии».
Другие приложения для агентов на своём сервере — в разделе ИИ-агенты на своём сервере. Если нужен готовый личный помощник, а не конструктор, посмотрите OpenClaw на VPS.
Реклама · АО «ТаймВэб»
Timeweb Cloud
Cloud MSK 80 — 4 ядра, 8 ГБ RAM, 80 ГБ NVMe: 7 000 ₽/мес при оплате за месяц. Списание почасовое, n8n есть в маркетплейсе.
Коротко
- Свой ИИ-агент — это n8n, модель и хотя бы один инструмент; собирается узлами без кода.
- Готовая сборка от n8n ставит n8n, Ollama, Qdrant и PostgreSQL одной командой Docker.
- До запуска смените пароли в
.envи привяжите порты к 127.0.0.1. - Модель нужна с меткой tools: в нашей проверке llama3.2 ошибалась в выражении для калькулятора, qwen3:4b считала верно, но на процессоре отвечала по пять минут.
- Сервер: 4 ГБ под модель по API, 8 ГБ под небольшую свою модель, видеокарта — под модели крупнее.
Плюсы и минусы
Преимущества
- Готовая сборка от разработчика n8n: n8n, Ollama, Qdrant и PostgreSQL одной командой
- Своя модель: данные не покидают сервер, токены не оплачиваются
- Агент собирается узлами в редакторе, без программирования
Недостатки
- Сборка, по словам самой n8n, не доведена для рабочей среды: HTTPS и копии настраиваете сами
- На процессоре модель отвечает медленнее, чем на видеокарте
- Небольшие модели чаще ошибаются в вызове инструментов, их надо проверять на своих задачах
Реклама · ООО «Админвпс»
AdminVPS
Start за 1 289 ₽/мес при оплате за месяц: 4 ядра 3,6 ГГц, 8 ГБ RAM, 80 ГБ NVMe — n8n и небольшая модель Ollama на одном сервере. n8n и Ollama есть в маркетплейсе AdminVPS. По промокоду EASYLINK первый месяц Start — 515,60 ₽: скидка 60 % при оплате за месяц.
Реклама · АО «ТаймВэб»
Timeweb Cloud
Cloud MSK 80 — 4 ядра, 8 ГБ RAM, 80 ГБ NVMe: 7 000 ₽/мес при оплате за месяц. Списание почасовое, n8n есть в маркетплейсе.
Частые вопросы
Сколько стоит свой ИИ-агент?
Программы бесплатны: n8n, Ollama, Qdrant и PostgreSQL ставятся одной сборкой. Платите за сервер, все цены — при оплате за месяц: с моделью по API — от 899 ₽/мес (AdminVPS Micro) плюс токены поставщику, со своей небольшой моделью — от 1 289 ₽/мес (AdminVPS Start), с видеокартой — 16 800 ₽/мес за Tesla T4 у Timeweb Cloud: карты AdminVPS от 7 749 ₽/мес с 21 октября 2026 года «нет в наличии».
Можно ли запустить агента без видеокарты?
Можно, с небольшой моделью: llama3.2 весит 2,0 ГБ, qwen3:4b — 2,5 ГБ, и обе умеют вызывать инструменты. На процессоре ответы медленнее: в нашей проверке 21 октября 2026 года на 4 vCPU — 5,7–5,9 токена в секунду у llama3.2 и 4,5–4,6 у qwen3:4b, а ответ агента с инструментом у qwen3:4b занял больше пяти минут. Под такую модель, n8n и базу берите сервер с 8 ГБ памяти — например, AdminVPS Start за 1 289 ₽/мес при оплате за месяц.
Какая модель нужна для агента в n8n?
Модель, которая умеет вызывать инструменты: в библиотеке Ollama у неё стоит метка tools — например, llama3.2 и qwen3. Подключается она к агенту узлом Ollama Chat Model. Узел Ollama Model инструменты не поддерживает, и документация n8n советует его только для простых цепочек без агента.
Чем ИИ-агент отличается от чат-бота?
Чат-бот отвечает текстом, а агент сам решает, какое действие выполнить, и вызывает инструмент — калькулятор, запрос к API, запись в таблицу. Поэтому в n8n агенту обязателен хотя бы один инструмент: без него узел AI Agent не запустится.
Уходят ли данные агента в интернет?
Со своей моделью через Ollama — нет: запросы обрабатываются на вашем сервере, а облачные модели самой Ollama отключает переменная OLLAMA_NO_CLOUD=1. Если подключить модель по API, запросы с данными уходят поставщику. Порты n8n, Ollama и Qdrant держите на 127.0.0.1: у API Ollama нет пароля, и открытый порт отдаёт вашу модель любому.
Где разместить агента, если он работает с персональными данными?
Если данные россиян по статье 18 152-ФЗ нужно хранить в России, берите сервер в российском дата-центре: VPS в России есть у AdminVPS и Timeweb Cloud, видеокарты в России у AdminVPS — RTX A4000 и A5000, но на 7 ноября 2026 года их нет в наличии. Одной площадки для закона мало, оценку соответствия даёт специалист по защите информации; мы её не даём.
Подобрать сервер под задачу
Смотреть тарифыРеклама · ООО «Админвпс»
Ссылки на провайдеров в этом материале партнёрские: если вы оформите услугу, мы получим комиссию. На цену для вас это не влияет. Подробнее
Об авторе