Коротко: что нужно и сколько это стоит
Ollama запускает открытые языковые модели — Qwen, Gemma, DeepSeek, gpt-oss — на вашем сервере, а Open WebUI даёт к ним интерфейс, похожий на ChatGPT. Обе программы бесплатны; платите только за сервер.
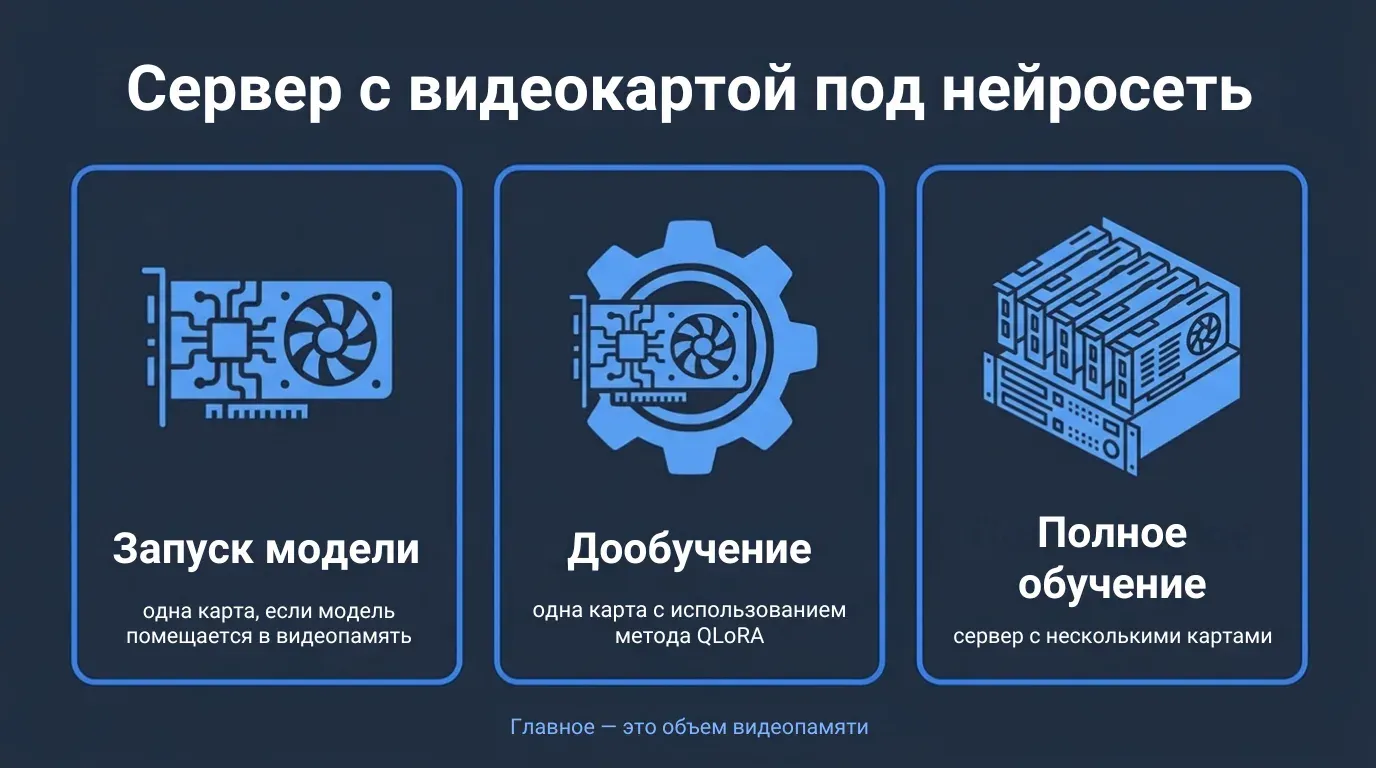
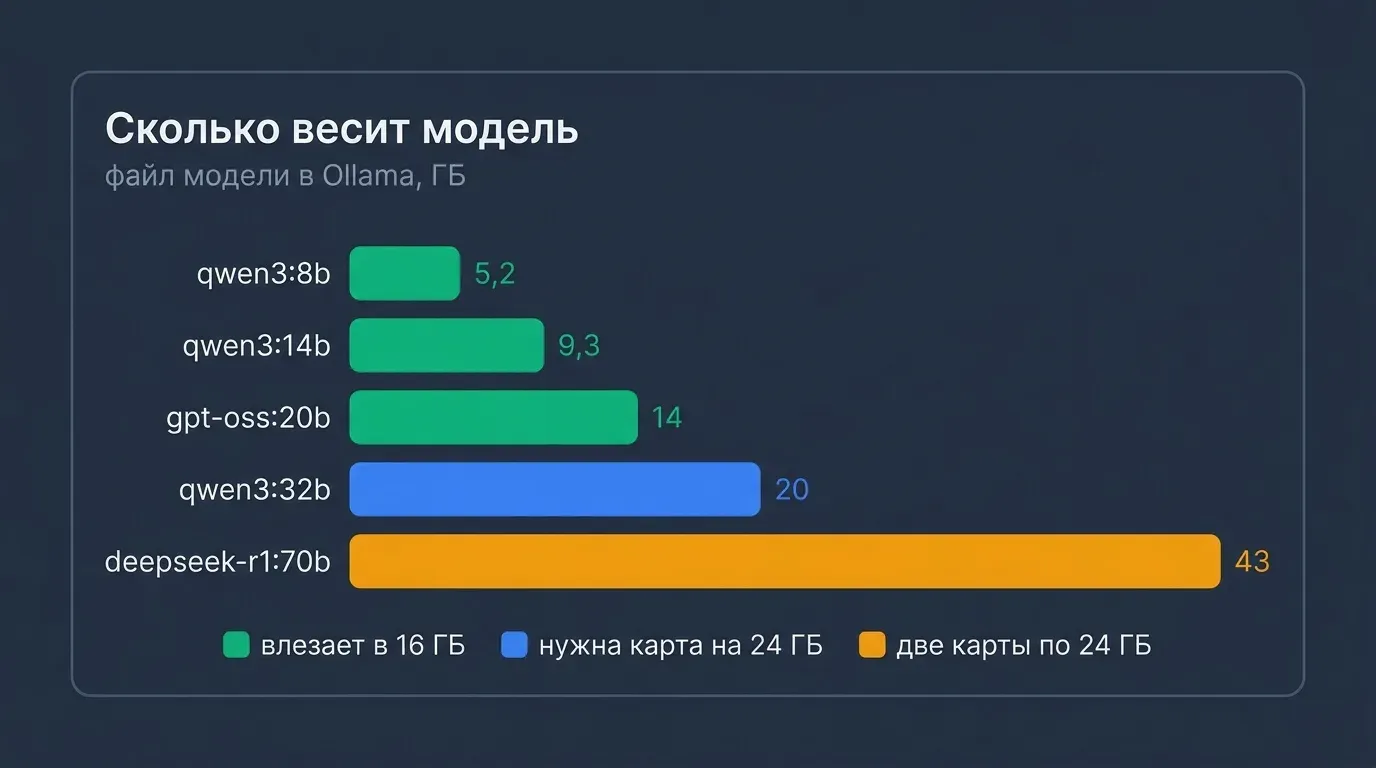
Главное правило: модель должна целиком поместиться в видеопамять. В 24 ГБ помещается qwen3:32b (файл 20 ГБ), в 16 ГБ — gpt-oss:20b (14 ГБ). Без видеокарты Ollama работает на процессоре, но медленнее — это путь для небольших моделей вроде qwen3:4b. GPU-серверы у AdminVPS — от 7 749 ₽/мес при оплате за месяц (GTX 1080 Ti, 11 ГБ, Исландия); в России — RTX A4000 за 10 959 ₽/мес и RTX A5000 за 17 709 ₽/мес при оплате за месяц. Цены сверены по странице провайдера 24.09.2026.
Сколько памяти нужно модели
Размер файла модели — первое число, на которое смотрят. Вот он для ходовых моделей по библиотеке Ollama на 24.09.2026:
qwen3:4b— 2,5 ГБ;qwen3:8b— 5,2 ГБ;qwen3:14b— 9,3 ГБ;qwen3:32b— 20 ГБgemma4:12b— 7,6 ГБ;gemma4:26b— 19 ГБdeepseek-r1:14b— 9,0 ГБ;deepseek-r1:32b— 20 ГБ;deepseek-r1:70b— 43 ГБgpt-oss:20b— 14 ГБ;gpt-oss:120b— 65 ГБllama3.2:3b— 2,0 ГБ
Сверху нужна память под контекст — то, что модель держит в голове во время разговора. По документации Ollama контекст по умолчанию зависит от видеопамяти: до 24 ГБ — 4 тысячи токенов, от 24 до 48 ГБ — 32 тысячи, от 48 ГБ — 256 тысяч. Для агентов, поиска и работы с кодом документация советует от 64 тысяч токенов, и чем длиннее контекст, тем больше памяти он занимает.
Не влезла модель в видеокарту — Ollama разложит её между видеопамятью и обычной памятью, и ответы станут медленнее. Проверка — команда ollama ps: в колонке PROCESSOR должно стоять 100% GPU.
Какой сервер брать под Ollama
Видеокарты с видеопамятью по возрастанию — у AdminVPS, цены при оплате за месяц, сверены 24.09.2026:
- GTX 1080 Ti, 11 ГБ — от 7 749 ₽/мес (Исландия; в Финляндии 9 409 ₽, в Нидерландах 9 959 ₽). Под qwen3:8b и gemma4:12b; qwen3:14b — впритык.
- RTX A4000, 16 ГБ, Россия — 10 959 ₽/мес. Под gpt-oss:20b и qwen3:14b.
- RTX A5000, 24 ГБ, Россия — 17 709 ₽/мес. Под qwen3:32b, gemma4:26b и deepseek-r1:32b.
- RTX 3090, 24 ГБ — 26 459 ₽/мес (Исландия).
- RTX 4090, 24 ГБ — от 28 669 ₽/мес (Исландия; в Нидерландах и Германии — 35 419 ₽).
- Две RTX 4090, 2 × 24 ГБ — 80 809 ₽/мес (Нидерланды). Сюда встаёт deepseek-r1:70b на 43 ГБ: модель, которая не влезает в одну карту, Ollama раскладывает по обеим. Связки NVLink у 4090 нет, данные идут по шине PCIe — это медленнее, чем в одной карте.
Все эти карты Ollama поддерживает: по документации нужны видеокарты NVIDIA с compute capability 5.0 и новее и драйвер от версии 550, а для GTX 1080 и 1080 Ti — от версии 570.
Если по статье 18 152-ФЗ данные россиян нужно хранить в России, из этого списка подходят только A4000 и A5000 — они размещены в России. 21.10.2026 корзина AdminVPS по всем GPU-тарифам отвечала «нет в наличии». У Timeweb Cloud готовый выделенный сервер с картой есть на странице выделенных серверов, за кнопкой «Показать ещё»: Tesla T4 на 16 ГБ — 16 800 ₽/мес при оплате за месяц; почасовой оплаты у GPU нет. Больше о видеокартах и ценах — в разделе GPU-серверы и в обзоре GPU-серверов.
Без видеокарты. Ollama работает и на процессоре, но медленнее. Для небольших моделей памяти должно хватать на файл модели и систему с запасом: у AdminVPS Start — 4 ядра 3,6 ГГц, 8 ГБ RAM и 80 ГБ NVMe за 1 289 ₽/мес при оплате за месяц.
Реклама · ООО «Админвпс»
RTX A5000 в России — 17 709 ₽ при оплате за месяц
24 ГБ видеопамяти, 8 ядер и 32 ГБ RAM, дата-центр в России. В эту карту целиком встают qwen3:32b и deepseek-r1:32b, а данные остаются на российской площадке.
Промокод EASYLINK — скидка 60 % на первый месяц при оплате за 1 месяц, кроме тарифов Lite.
Шаг 1. Установить Ollama
На Linux официальный установщик ставит Ollama и запускает её службой — документация Ollama для Linux:
curl -fsSL https://ollama.com/install.sh | sh

# проверить, что служба работает
ollama -v
sudo systemctl status ollama

# на сервере с видеокартой NVIDIA — видит ли система карту
nvidia-smi
Своя установка слушает только 127.0.0.1:11434 — снаружи к ней не подключиться, и это правильно. Первая модель и первый разговор:
ollama run qwen3:8bВариант в Docker — по документации Ollama: сначала NVIDIA Container Toolkit, затем контейнер с доступом к видеокарте. В документации порт указан как -p 11434:11434 — на сервере это открытый наружу API без пароля, поэтому привязываем его к 127.0.0.1:
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker

docker run -d --gpus=all -v ollama:/root/.ollama -p 127.0.0.1:11434:11434 --name ollama ollama/ollama
docker exec -it ollama ollama run qwen3:8b
Шаг 2. Open WebUI: интерфейс как у ChatGPT
Проще всего — образ Open WebUI со встроенной Ollama: один контейнер, модели и чаты в томах Docker. Команда из README Open WebUI; на сервере без видеокарты уберите --gpus=all, а порт снова закрываем от внешнего мира:
docker run -d -p 127.0.0.1:3000:8080 --gpus=all -v ollama:/root/.ollama -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:ollamaИнтерфейс виден только с самого сервера. Открыть его со своего компьютера можно через SSH-туннель, а для постоянной работы — через домен с HTTPS, как в статьях про Nginx и про SSL-сертификат.
ssh -L 3000:localhost:3000 user@IP_СЕРВЕРА
# затем в браузере: http://localhost:3000
Первым делом создайте учётную запись: по документации Open WebUI первая учётная запись становится администратором и управляет пользователями и всеми настройками. Модели скачиваются по имени из библиотеки Ollama, например qwen3:8b.
Шаг 3. API: подключить свои программы
К этому API подключают и ИИ-агента — модель, которая сама вызывает инструменты. Как собрать его в n8n на том же сервере, разобрано отдельно.
У Ollama есть REST API на том же порту 11434 — к нему подключают свои скрипты, ботов и агентов. Пример из README Ollama, с моделью из этой статьи:
curl http://localhost:11434/api/chat -d '{
  "model": "qwen3:8b",
  "messages": [{"role": "user", "content": "Почему небо голубое?"}],
  "stream": false
}'
По словам разработчика, при локальной работе Ollama не видит ваших запросов и данных. Облачные функции — облачные модели и веб-поиск — выключаются переменной OLLAMA_NO_CLOUD=1: тогда Ollama работает только на вашем сервере. Если нужен готовый помощник в мессенджерах поверх Ollama, в документации Ollama есть интеграция с OpenClaw — о нём отдельная статья.
Что ломается
- API наружу. Команда Docker из документации открывает порт 11434 всем, а пароля у API Ollama нет. На сервере — только
127.0.0.1:11434. - Модель не влезла в видеокарту.
ollama psпоказывает деление CPU/GPU, ответы медленнее. Берите модель меньше или карту с большей памятью. - Длинный контекст. Для агентов нужен контекст от 64 тысяч токенов, и он занимает видеопамять сверх файла модели.
- Старый драйвер NVIDIA. GTX 1080 и 1080 Ti работают с драйвером от версии 570, новые карты — от 550.
- Чужой администратор. Первая учётная запись в Open WebUI — администратор. Не оставляйте интерфейс открытым до регистрации.
- Несколько пользователей сразу. По умолчанию модель отвечает на один запрос за раз (
OLLAMA_NUM_PARALLEL=1). Больше параллельных запросов — больше памяти: она растёт вместе с числом запросов и длиной контекста.
Коротко
- Ollama и Open WebUI бесплатны, платите только за сервер.
- Модель должна целиком поместиться в видеопамять: 24 ГБ — до qwen3:32b, 16 ГБ — gpt-oss:20b.
- GPU у AdminVPS — от 7 749 ₽/мес при оплате за месяц; в России — A4000 за 10 959 ₽ и A5000 за 17 709 ₽.
- Порты Ollama и Open WebUI — только на 127.0.0.1; снаружи — через туннель или HTTPS.
- Проверка, что модель на видеокарте: ollama ps, колонка PROCESSOR.
Плюсы и минусы
Преимущества
- Модели и чаты — на вашем сервере
- Ollama и Open WebUI бесплатны
- Выбор моделей: Qwen, Gemma, DeepSeek, gpt-oss
- REST API для своих программ
Недостатки
- Без видеокарты ответы медленнее
- GPU-серверы — от 7 749 ₽/мес при оплате за месяц
- Защита API и интерфейса — на вас
- Модели на 70B требуют две видеокарты
Реклама · ООО «Админвпс»
AdminVPS — GPU-серверы в России
RTX A4000 с 16 ГБ — 10 959 ₽/мес, RTX A5000 с 24 ГБ — 17 709 ₽/мес при оплате за месяц. Обе в российском дата-центре.
Промокод EASYLINK — скидка 60 % на первый месяц при оплате за 1 месяц, кроме тарифов Lite.
Реклама · ООО «Админвпс»
AdminVPS — RTX 4090 под крупные модели
24 ГБ видеопамяти, 8 ядер, 64 ГБ RAM — от 28 669 ₽/мес при оплате за месяц (Исландия). Две 4090 для моделей на 70B — 80 809 ₽/мес при оплате за месяц (Нидерланды).
Промокод EASYLINK — скидка 60 % на первый месяц при оплате за 1 месяц, кроме тарифов Lite.
Частые вопросы
Сколько стоит свой ChatGPT на сервере?
Сами Ollama и Open WebUI бесплатны — платите за сервер. GPU-серверы у AdminVPS — от 7 749 ₽/мес при оплате за месяц (GTX 1080 Ti, 11 ГБ, Исландия); в России — RTX A4000 с 16 ГБ за 10 959 ₽/мес и RTX A5000 с 24 ГБ за 17 709 ₽/мес при оплате за месяц.
Можно ли запустить Ollama без видеокарты?
Можно: Ollama работает и на процессоре, но медленнее. Это путь для небольших моделей вроде qwen3:4b с файлом 2,5 ГБ. Памяти сервера должно хватать на файл модели и систему с запасом — например, AdminVPS Start с 8 ГБ RAM за 1 289 ₽/мес при оплате за месяц.
Какая видеокарта нужна для qwen3:32b или DeepSeek?
Для qwen3:32b и deepseek-r1:32b с файлами по 20 ГБ нужна карта на 24 ГБ: RTX A5000, 3090 или 4090. deepseek-r1:70b весит 43 ГБ и встаёт только на две карты по 24 ГБ — Ollama разложит модель по обеим, но это медленнее, чем в одной карте.
Уходят ли мои запросы в интернет?
По словам разработчика, при локальной работе Ollama не видит ваших запросов и данных. Облачные функции — облачные модели и веб-поиск — выключаются переменной OLLAMA_NO_CLOUD=1, после чего Ollama работает только на вашем сервере. Это стоит сделать, если через модель идут данные клиентов.
Как проверить, что модель работает на видеокарте?
Командой ollama ps: в колонке PROCESSOR должно стоять 100% GPU. Если там деление вроде 48%/52% CPU/GPU, модель не поместилась в видеопамять целиком и ответы будут медленнее — берите модель меньше или карту с большей памятью. Проверяйте после каждой смены модели или длины контекста.
Можно ли подключить Ollama к своим программам?
Да: у Ollama есть REST API на порту 11434 — к нему подключают скрипты, ботов и агентов. На сервере порт должен слушать только 127.0.0.1: пароля у API нет, и открытый наружу порт даёт вашу модель любому. Для доступа снаружи ставят прокси с паролем и HTTPS.
GPU-сервер под Ollama — AdminVPS
Выбрать GPUРеклама · ООО «Админвпс»
Статья содержит партнёрские ссылки. При переходе и покупке мы получаем комиссию без дополнительных затрат для вас. Подробнее
Об авторе