Спрос на GPU-серверы в России есть, и он не только у крупных компаний. Обучение нейросетей, дообучение больших языковых моделей и работа готовой модели в реальном времени требуют оборудования, которого у обычного VPS нет.
Аренда GPU-серверов у двух наших провайдеров на 21.10.2026 выглядит так: у Timeweb Cloud готовый выделенный сервер с Tesla T4 продаётся за 16 800 ₽/мес при оплате за месяц, у AdminVPS прайс открыт, но заказы GPU приостановлены. Почасовой аренды нет ни у одного. Карты доходят до NVIDIA A100, H100 и H200 — по предзаказу у Timeweb Cloud. Ниже — что из этого можно взять сейчас, что только по заявке и какая карта нужна под вашу задачу.
Раскрытие информации: Этот материал содержит партнёрские ссылки. При покупке через наши ссылки мы получаем комиссию без дополнительных затрат для вас.
Спрос на GPU-сервер есть не только у тех, кто обучает модели. Запуск готовой модели у себя (Llama 3.1, Mistral, Gemma 2), генерация изображений (Stable Diffusion XL, Flux), дообучение под свои данные и научные расчёты — всё это упирается в объём видеопамяти.
В этом обзоре мы рассмотрим, где арендовать GPU-серверы в России, какие видеокарты подходят для разных задач и как оптимизировать затраты на GPU-вычисления.
Сколько стоит арендовать GPU-сервер и где его можно купить сейчас
На 21.10.2026 картина у двух наших провайдеров такая: купить GPU-сервер сразу можно только у Timeweb Cloud, и только помесячно. У Timeweb Cloud выделенный сервер с Tesla T4 — 16 800 ₽/мес при оплате за месяц; у AdminVPS прайс открыт, но заказы приостановлены. Ниже — что именно мы видели 21.10.2026 и как проверить это самому перед заказом.
AdminVPS публикует пятнадцать конфигураций с ценами (сверены со страницей провайдера 21 октября 2026 года, все — при оплате за месяц), но в тот же день корзина по каждой из пятнадцати отвечала: «Данного продукта сейчас нет в наличии, поэтому заказы временно приостановлены». Прайс — на то время, когда карты вернутся:
- GTX 1080 Ti в Исландии — 7 749 ₽/мес, самая доступная ступень;
- RTX A4000 в России — 10 959 ₽/мес;
- RTX A5000 в России — 17 709 ₽/мес;
- RTX 3090 в Исландии — 26 459 ₽/мес;
- RTX 4090 — 28 669 ₽/мес на площадке в Исландии и 35 419 ₽/мес в Нидерландах и Германии.
У Timeweb Cloud на странице GPU-серверов цен нет ни одной. Вместо них сказано: «Минимальный авансовый платёж — от 5 000 ₽» и предложено оставить заявку — стоимость считают под проект. В перечне карт — Tesla T4, GeForce от GTX 1080 до RTX 4090 и серия A до A6000; A100, H100 и H200 идут по предзаказу. На сервер ставят от одной до четырёх карт, больше — по запросу. Серверы с RTX 5090 на 32 ГБ GDDR7 вынесены на отдельную страницу — цены там тоже нет, оплата заявлена помесячной. Готовые конфигурации с ценой у Timeweb Cloud есть в другом месте — на странице выделенных серверов, в списке за кнопкой «Показать ещё»: Tesla T4 на 16 ГБ, процессор Core i3-14100, 32 ГБ памяти и два NVMe по 1 ТБ — 16 800 ₽/мес при оплате за месяц.
Почасовой аренды GPU нет ни у одного из двух. У AdminVPS вся линейка размечена помесячно: слова «почасовая» на странице GPU-серверов нет ни разу — проверено 30.08, 01.09 и 26.09.2026. На странице GPU у Timeweb Cloud написано «тарифы формируются за месяц, а списания — раз в час», но на наш вопрос об аренде сервера с Tesla T4 на несколько часов поддержка 21.10.2026 ответила: почасовой и посуточной оплаты у GPU-серверов нет, только помесячная. Нужна карта на пару часов — для разового прогона или дообучения — у наших провайдеров так не выйдет: считайте месяц.
Практический вывод на 21.10.2026. Нужен GPU-сервер сегодня — у Timeweb Cloud это выделенный сервер с Tesla T4 за 16 800 ₽/мес при оплате за месяц; 16 ГБ видеопамяти хватает на сжатые модели до 14B. Нужны A100 или H100 под обучение — у Timeweb Cloud они выставлены под предзаказ, через заявку. Младшие карты AdminVPS дешевле, но их сейчас не продают — откройте корзину, прежде чем закладывать их в бюджет.
Зачем арендовать сервер с видеокартой под нейросети
GPU (графический процессор) выполняет тысячи операций одновременно, а на таких параллельных вычислениях построено машинное обучение. Одна NVIDIA A100 содержит 6 912 CUDA-ядер для вычислений одинарной точности — так в описании архитектуры Ampere на сайте NVIDIA.
Основные сценарии использования GPU серверов:
- Обучение нейросетей (training) — самый ресурсоёмкий процесс. Сколько часов займёт дообучение, зависит от модели, объёма данных и метода — общего числа здесь нет.
- Инференс (inference) — запуск обученной модели для предсказаний. Требует меньше GPU-памяти, но нужна низкая задержка.
- Обработка данных — NLP, компьютерное зрение, генерация изображений (Stable Diffusion, Midjourney-подобные модели).
- Научные вычисления — молекулярная динамика, климатические модели, финансовое моделирование.
Центральные процессоры (CPU) оптимизированы для последовательного выполнения сложных операций, тогда как GPU содержат тысячи простых ядер, работающих параллельно. Для задач машинного обучения, где нужно одновременно обрабатывать миллионы математических операций (матричные умножения, свёртки), GPU справляется быстрее CPU; во сколько раз — зависит от задачи и конкретных процессоров, своих замеров мы не проводили.
Типичные задачи, требующие GPU на VPS: обучение нейросетей (fine-tuning, LoRA), инференс больших языковых моделей (Llama 3.1, Mistral, Qwen), генерация изображений (Stable Diffusion, DALL-E), обработка видео (кодирование, upscaling), научные вычисления (молекулярная динамика, CFD), криптографические вычисления и рендеринг 3D-графики.
Для простого инференса небольших моделей (до 7B параметров) иногда можно обойтись мощным CPU с поддержкой AVX-512 и достаточным объёмом RAM. Но для обучения, работы с моделями от 13B параметров и генерации изображений в высоком разрешении GPU не имеет альтернативы.
Какая видеокарта нужна для нейросетей
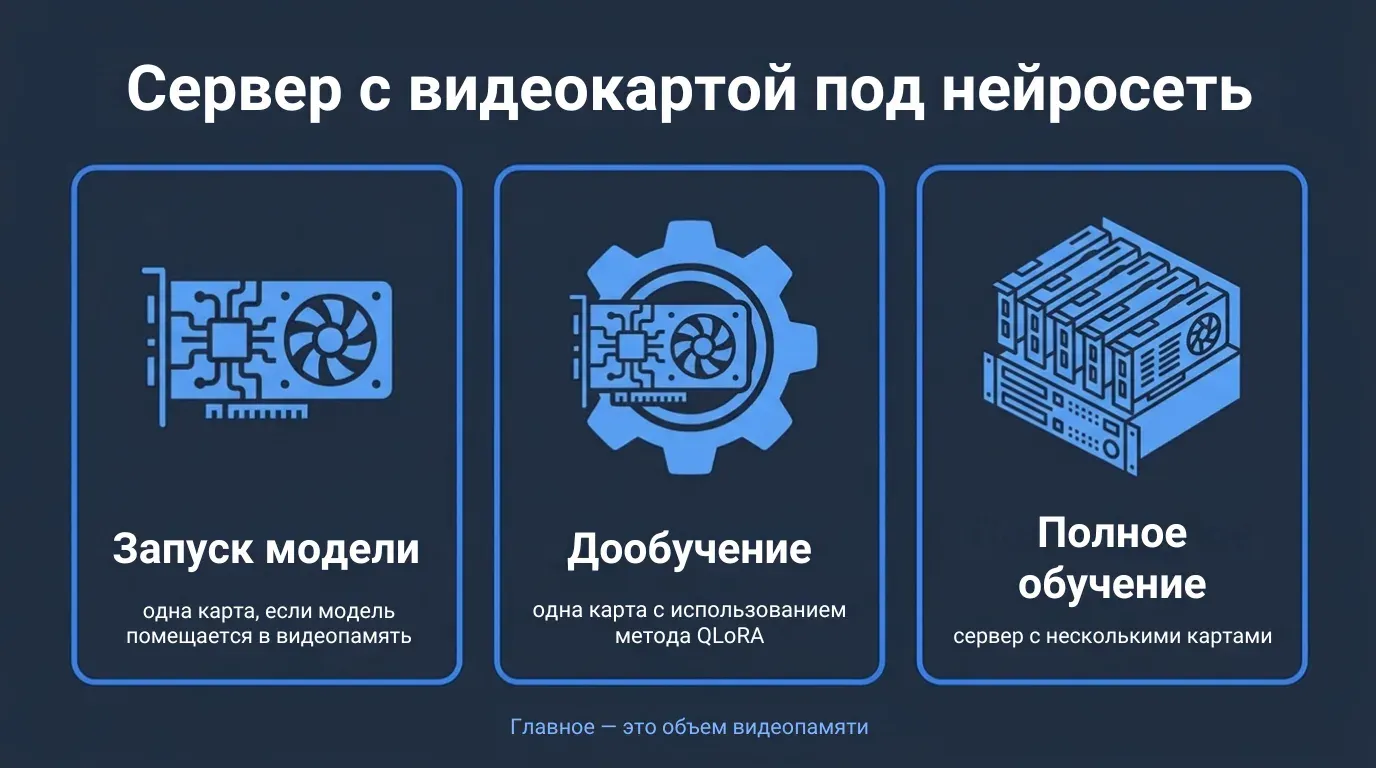
Инференс малых моделей: подойдёт карта на 8–12 ГБ — например, RTX 3060 на 12 ГБ или RTX 4060 на 8 ГБ VRAM. В полной точности (FP16) на такую карту помещаются модели до 3–5B параметров, в сжатом виде, в каком их раздаёт Ollama, — до 8–14B: файл qwen3:8b весит 5,2 ГБ, qwen3:14b — 9,3 ГБ. Открытой цены на RTX 3060 и 4060 у наших двух провайдеров нет; карты того же объёма в прайсе AdminVPS — GTX 1080 Ti на 11 ГБ за 7 749 ₽/мес в Исландии и GTX 1080 на 8 ГБ за 8 299 ₽/мес в Нидерландах, обе цены при оплате за месяц. Достаточно для чат-ботов, классификации текста и небольших генеративных задач.
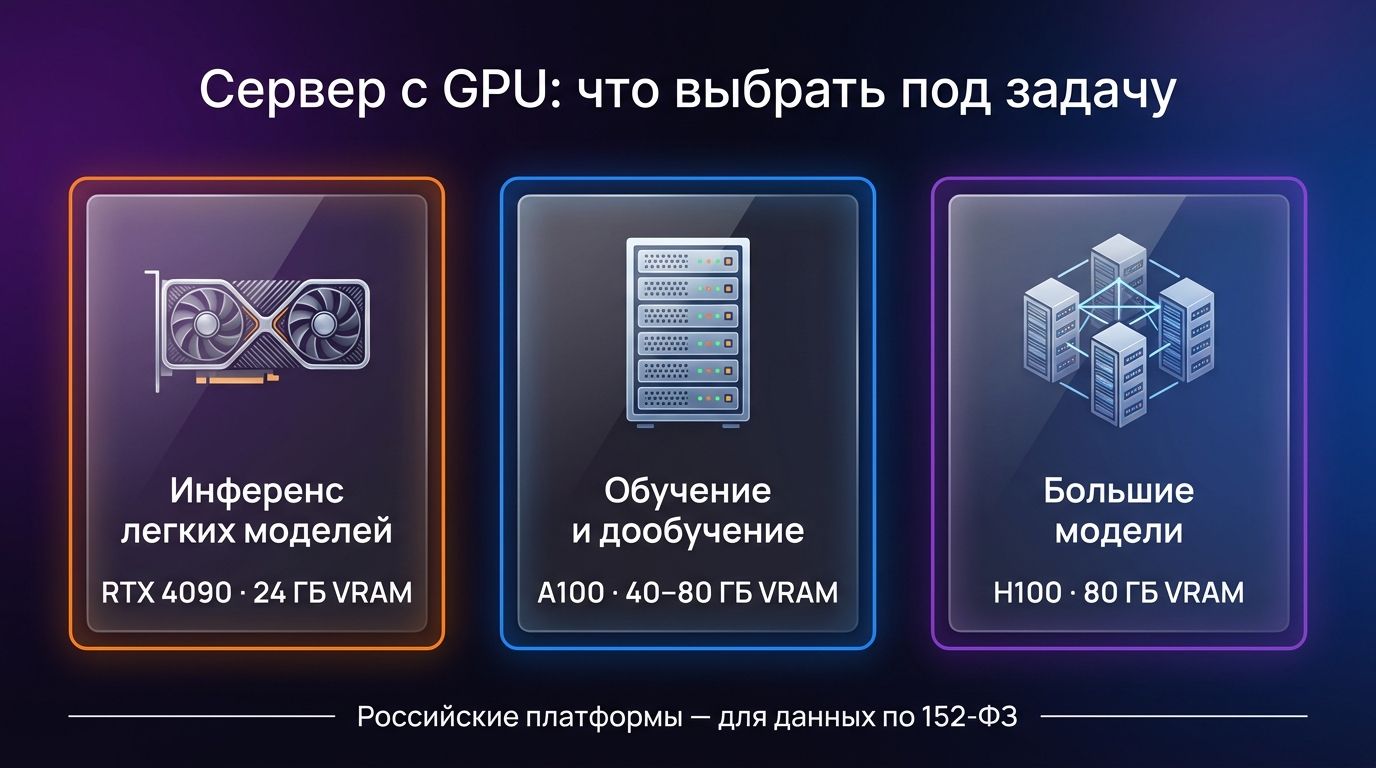
Дообучение моделей 7B–13B на одной карте — методом QLoRA, где сама модель хранится сжатой: хватит NVIDIA A100 40 ГБ или RTX 4090 24 ГБ. У AdminVPS RTX 4090 стоит 28 669 ₽/мес при оплате за месяц на площадке в Исландии; A100 в открытом прайсе нет ни у одного из двух. Сколько это займёт, зависит от модели и датасета; своих замеров у нас нет.
Полное дообучение крупных моделей (30B+) не помещается в одну карту даже на 80 ГБ: нужен сервер с несколькими A100 или H100, где GPU связаны NVLink. Открытой цены на такие конфигурации нет ни у AdminVPS, ни на странице GPU у Timeweb Cloud — считают по заявке. Обучение может занимать дни и недели.
Stable Diffusion и генерация изображений: для SDXL Stability AI при выпуске называла минимумом карту уровня RTX 20-й серии с 8 ГБ VRAM; запас сверх минимума пригодится — о нём ниже.
Главный параметр — объём видеопамяти (VRAM). Модель должна полностью поместиться в VRAM GPU для эффективной работы.
Для инференса моделей критически важен объём VRAM. В библиотеке Ollama Llama 3.1 8B в сжатом виде Q4 весит 4,9 ГБ, 70B — 43 ГБ; в полной точности FP16 те же модели весят 16 и 141 ГБ — втрое с лишним больше. RTX 4090 с 24 ГБ VRAM вмещает сжатые модели примерно до 30B (qwen3:32b весит 20 ГБ), а 70B не помещается даже в самом сильном сжатии из библиотеки Ollama: вариант Q2_K весит 26 ГБ, и часть модели уйдёт в оперативную память, где считается медленнее.
Для обучения и fine-tuning требуется значительно больше VRAM из-за хранения градиентов и состояния оптимизатора. Разницу показали авторы метода QLoRA: обычное дообучение модели на 65B в 16 битах требует больше 780 ГБ видеопамяти, а их способ — сжатая модель и небольшие обучаемые добавки — укладывается в одну карту на 48 ГБ. По той же пропорции полное дообучение даже модели на 7B не помещается в одну карту на 80 ГБ, поэтому на одной карте дообучают методами LoRA и QLoRA.
Для генерации изображений через Stable Diffusion XL названные Stability AI 8 ГБ VRAM — минимум, а не запас: ControlNet, несколько моделей в одном конвейере ComfyUI и крупные модели вроде Flux займут больше, сколько именно — смотрите в описании конкретной модели.
Где арендовать GPU-сервер в России: два провайдера
Российский рынок GPU-серверов шире двух наших провайдеров; из тех, кого мы сравниваем, предложения такие:
Timeweb Cloud: GPU-конфигурации с Tesla T4, картами GeForce и серии A; A100, H100 и H200 — только по предзаказу. Готовый выделенный сервер с Tesla T4 — 16 800 ₽/мес при оплате за месяц; почасовой оплаты у GPU нет (так нам сказала поддержка 21.10.2026), остальное считают по заявке. В том же облаке есть S3-хранилище.
AdminVPS: профессиональные карты NVIDIA. В российских дата-центрах — RTX A4000 на 16 ГБ за 10 959 ₽/мес и A5000 на 24 ГБ за 17 709 ₽/мес (обе цены при оплате за месяц), обе с 32 ГБ RAM и каналом 1 Гбит/с. Игровые 3090 и 4090 доступны только в зарубежных ЦОД. 21.10.2026 корзина по всем GPU-тарифам AdminVPS отвечала «нет в наличии».
Карты корпоративного класса: A100, H100 и H200 у Timeweb Cloud открыты по предзаказу — это вариант для обучения больших моделей, а не только инференса.
При выборе GPU-провайдера обратите внимание на несколько ключевых факторов: тип и поколение видеокарты, объём VRAM, тип подключения (PCIe Gen4 vs Gen5), наличие NVLink для multi-GPU, объём RAM и NVMe-хранилища, а также модель тарификации (почасовая vs помесячная).
Помесячная аренда подходит при постоянной нагрузке: круглосуточная работа модели, обучение длительностью в дни. Почасовое списание удобно для эпизодических задач — генерация датасетов, периодическое дообучение, пакетная обработка. Только у наших двух провайдеров выбора нет: почасовой аренды GPU нет ни у одного, AdminVPS размечает линейку помесячно, а поддержка Timeweb Cloud 21.10.2026 ответила так же — только месяц. Для разовых задач на GPU-сервере придётся платить за месяц или считать задачу на облачном API.
Timeweb Cloud: Tesla T4 с ценой, остальное по заявке
Timeweb Cloud предлагает GPU-конфигурации на базе NVIDIA T4; A100, H100 и H200 идут по предзаказу. На странице GPU цен нет — заявка и авансовый платёж от 5 000 ₽, — но на странице выделенных серверов, в списке за кнопкой «Показать ещё», есть готовый: Tesla T4 на 16 ГБ, Core i3-14100, 32 ГБ памяти, два NVMe по 1 ТБ — 16 800 ₽/мес при оплате за месяц. Фраза о списаниях «раз в час» на странице GPU есть, но поддержка 21.10.2026 ответила нам, что GPU-серверы сдаются только помесячно — на часы и дни их не берут.
Готовых образов с PyTorch и TensorFlow в маркетплейсе Timeweb Cloud мы не нашли (проверено 26.09.2026). Объектное хранилище S3 в том же облаке позволяет хранить датасеты отдельно от серверов.
Timeweb Cloud предоставляет GPU-серверы на базе NVIDIA A100 и других карт корпоративного класса — по предзаказу. Для облачных серверов у провайдера есть API, CLI и Terraform; можно ли так же заказывать и гасить GPU-серверы, на их странице не сказано. Гасить сервер ради экономии смысла нет: оплата всё равно за месяц.
Для серьёзных ML-проектов на сервер ставят от одной до четырёх карт, больше — по запросу: это и есть конфигурации с несколькими GPU.
Реклама · АО «ТаймВэб»
Timeweb Cloud — GPU серверы
Tesla T4 — 16 800 ₽/мес при оплате за месяц
AdminVPS: открытый прайс и карты в российских ЦОД
У AdminVPS профессиональные карты в российских дата-центрах выставлены по открытой цене, но 21.10.2026 корзина по всем GPU-тарифам отвечала «нет в наличии, заказы временно приостановлены» — перед заказом проверьте её сами. Тариф vGPU.v1-a4000: RTX A4000 с 16 ГБ VRAM, 8 vCPU, 32 ГБ RAM и 240 ГБ SSD за 10 959 ₽/мес при оплате за месяц. Старше — vGPU.v1-a5000: A5000 с 24 ГБ VRAM и NVMe-диском за 17 709 ₽/мес, тоже при оплате за месяц.
Профессиональные карты серии A отличаются от игровых памятью с коррекцией ошибок (ECC) и рассчитаны на непрерывную нагрузку. 24 ГБ VRAM у A5000 хватает, чтобы запускать сжатые модели примерно до 30B (qwen3:32b весит 20 ГБ) и дообучать модели 7B–13B методом QLoRA.
Игровые 3090 и 4090 у AdminVPS есть, но только в зарубежных дата-центрах: 3090 — 26 459 ₽/мес в Исландии, 4090 — 28 669 ₽/мес там же и 35 419 ₽/мес в Нидерландах и Германии, все цены при оплате за месяц. Если базы с персональными данными россиян по 152-ФЗ должны быть в России, из этой линейки по месту размещения подходят только A4000 и A5000.
Реклама · ООО «Админвпс»
AdminVPS — GPU-серверы в российских ЦОД
RTX A4000 за 10 959 ₽/мес и A5000 за 17 709 ₽/мес в дата-центрах России, обе цены при оплате за месяц. В списке приложений для AI на странице провайдера — PyTorch, TensorFlow и JupyterLab; техподдержка круглосуточная, время реакции по заявлению провайдера — до 15 минут.
Промокод EASYLINK — скидка 60 % на первый месяц при оплате за 1 месяц, кроме тарифов Lite.
Как выбрать GPU-сервер под свой проект
Выбор GPU-сервера зависит от конкретной задачи и бюджета. Вот пошаговый алгоритм:
- Определите объём VRAM по размеру модели: в библиотеке Ollama сжатая модель на 8B весит около 5 ГБ и помещается в карту на 8 ГБ, на 32B — 20 ГБ и требует 24 ГБ (RTX 4090, A5000), на 70B — 43 ГБ, то есть нужно 48 ГБ и больше: две RTX 4090 или A100 80 ГБ.
- Выберите, где брать: у обоих наших провайдеров GPU-серверы только помесячные; у AdminVPS прайс открыт, но 21.10.2026 заказы GPU приостановлены, у Timeweb Cloud цена есть у готового выделенного сервера с Tesla T4 (16 800 ₽/мес при оплате за месяц), остальное — по заявке.
- Проверьте совместимость CUDA: убедитесь, что провайдер предоставляет нужную версию драйвера NVIDIA и CUDA Toolkit для вашего фреймворка.
- Оцените CPU и RAM: для предобработки данных и загрузки моделей нужны мощный CPU и достаточный объём RAM: модель по пути в видеопамять обычно проходит через оперативную.
- Тестируйте перед покупкой: запустите реальную задачу и замерьте скорость инференса (tokens/sec) и обучения (samples/sec).
Начинать разумно с младшей карты, в которую помещается ваша модель, а к RTX 4090 переходить, когда понадобятся 24 ГБ видеопамяти. Для серьёзного обучения моделей потребуются A100 или H100, а для запуска сжатой LLM на 70B — 48 ГБ видеопамяти и больше.
Что настроить сразу после аренды GPU-сервера
После аренды GPU-сервера выполните базовую оптимизацию для максимальной производительности:
- Установите последние драйверы NVIDIA и CUDA Toolkit. Используйте nvidia-smi для мониторинга загрузки GPU, температуры и потребления памяти.
- Для инференса LLM используйте vLLM или llama.cpp — они оптимизированы для максимальной скорости генерации токенов и эффективного использования VRAM.
- Включите Flash Attention 2 для трансформерных моделей — на длинных контекстах он заметно экономит память и время; насколько именно, зависит от модели и длины контекста.
- Используйте квантизацию (GPTQ, AWQ, GGUF) для запуска больших моделей на ограниченном VRAM. Качество при сжатии падает, и тем сильнее, чем сильнее сжатие; Q4 — вариант по умолчанию в библиотеке Ollama, а насколько потеря заметна, проверяйте на своей задаче.
- Настройте swap на NVMe для обработки пиков потребления RAM при загрузке моделей.
Для мониторинга используйте nvtop (аналог htop для GPU), Prometheus с nvidia_gpu_exporter или встроенные метрики облачной платформы. Отслеживайте утилизацию GPU — если карта подолгу недогружена, возможно, узким местом является CPU или ввод-вывод данных.
Когда GPU-сервер не нужен: обычный CPU и облачные API
Не для всех задач необходим выделенный GPU. Для запуска небольших моделей (до 7B) с квантизацией GGUF хватит обычного VPS с мощным процессором. Llama.cpp работает на процессорах с поддержкой AVX-512 (Intel Xeon Sapphire Rapids, AMD EPYC Genoa), но скорость будет заметно ниже, чем на видеокарте: своих замеров мы не проводили и чисел не называем.
Другая альтернатива — облачные API (OpenAI, Anthropic, Google). Для приложений с непостоянной нагрузкой оплата за токены может быть экономичнее аренды GPU-сервера. Где именно проходит граница, зависит от вашей модели, тарифа выбранного API и того, сколько сервер простаивает: считать нужно по своим числам, общего порога здесь нет.
Гибридный подход — использовать собственный GPU-сервер для основной нагрузки и облачный API как fallback при пиках или для задач, требующих моделей, которые нельзя запустить локально (GPT-4o, Claude Opus).
Пример: своя нейросеть на арендованном GPU-сервере
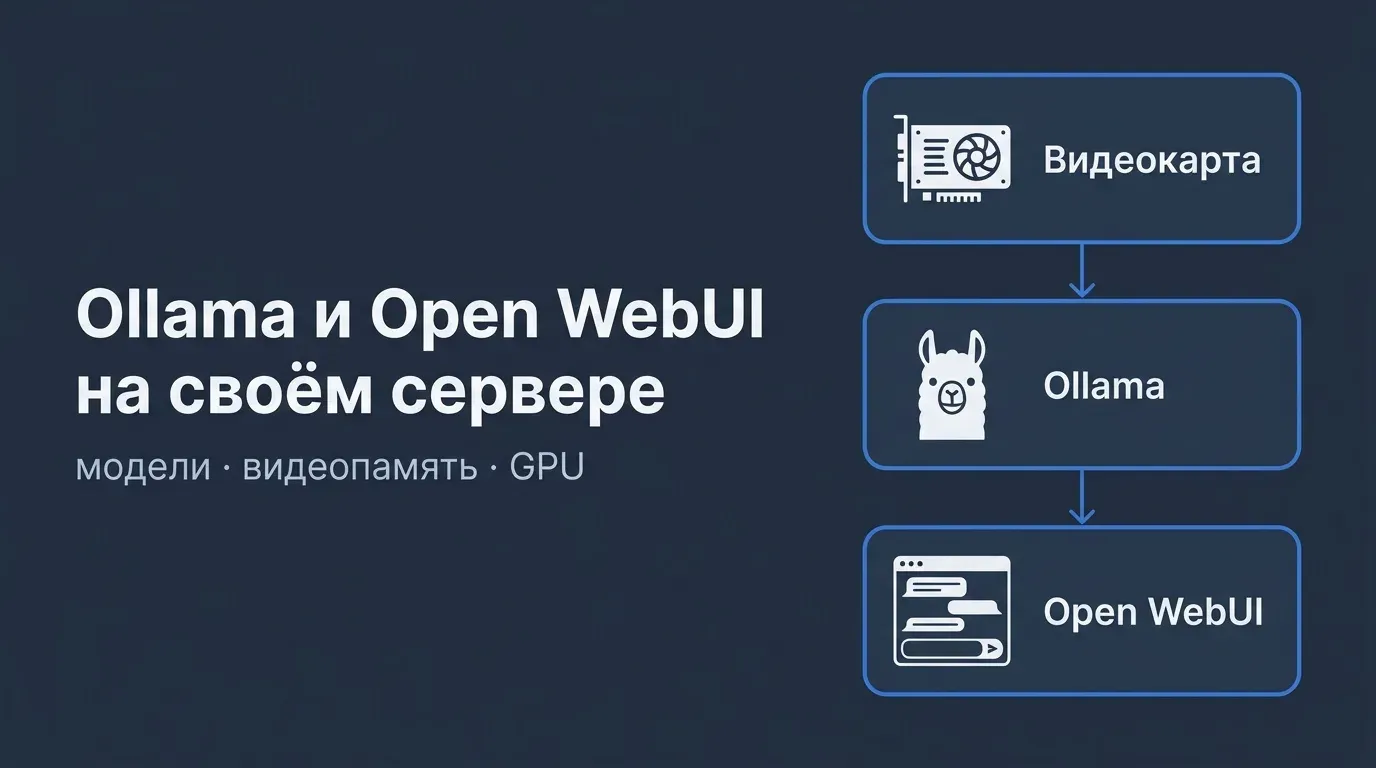
Ollama — открытая программа для локального запуска LLM. Рассмотрим пошаговую настройку на GPU VPS:
- Возьмите сервер с картой, в память которой помещается модель. Для примера — RTX 4090 на 24 ГБ: у AdminVPS это тариф vGPU.v3-4090 — 8 vCPU, 64 ГБ RAM и 240 ГБ NVMe за 28 669 ₽/мес при оплате за месяц в Исландии. У Timeweb Cloud RTX 4090 есть в перечне карт на странице GPU; готовая карта с ценой, которую мы сверили, — Tesla T4 на 16 ГБ за 16 800 ₽/мес при оплате за месяц: llama3.1:8b (4,9 ГБ) в неё помещается. 21.10.2026 GPU-тарифы AdminVPS в корзине — «нет в наличии».
- Поставьте драйвер NVIDIA, если его нет. Для серверов Ubuntu рекомендует
sudo ubuntu-drivers install --gpgpuи пакет nvidia-utils той же ветки — в нём утилитаnvidia-smi. После перезагрузкиnvidia-smiдолжна показать карту. - Поставьте Docker и NVIDIA Container Toolkit — без него контейнер не видит видеокарту. Шаги для toolkit — из официальной инструкции Ollama, для Ubuntu и Debian:
sudo apt-get update && sudo apt-get install -y docker.io

curl -fsSL https://nvidia.github.io/libnvidia-container/gpgkey \
  | sudo gpg --dearmor -o /usr/share/keyrings/nvidia-container-toolkit-keyring.gpg
curl -fsSL https://nvidia.github.io/libnvidia-container/stable/deb/nvidia-container-toolkit.list \
  | sed 's#deb https://#deb [signed-by=/usr/share/keyrings/nvidia-container-toolkit-keyring.gpg] https://#g' \
  | sudo tee /etc/apt/sources.list.d/nvidia-container-toolkit.list
sudo apt-get update && sudo apt-get install -y nvidia-container-toolkit

sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker

# проверка: контейнер должен увидеть карту
docker run --rm --gpus all ubuntu nvidia-smi- Запустите Ollama:
docker run -d --gpus=all -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama. - Загрузите модель:
docker exec -it ollama ollama pull llama3.1:8b— файл модели весит 4,9 ГБ, карте на 24 ГБ этого хватает с запасом. - Для веб-интерфейса поставьте Open WebUI:
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:main— он откроется на порту 3000.
После установки Ollama будет доступна через API на порту 11434. Скорость инференса Llama 3.1 8B на RTX 4090 зависит от модели, квантизации и самой карты. Своих замеров мы не проводили, поэтому чисел не называем: разумнее замерить собственную задачу сразу после запуска — с ключом --verbose (docker exec -it ollama ollama run llama3.1:8b --verbose) Ollama печатает скорость строкой eval rate, в токенах в секунду.
Для production-использования настройте reverse proxy через Nginx с SSL-сертификатом, ограничьте доступ по IP или добавьте аутентификацию. Учтите: порт, опубликованный через docker run -p, Docker открывает в обход правил UFW — это прямо сказано в его документации, так что закрытый в UFW порт 11434 всё равно виден из интернета. Мониторьте температуру GPU через nvidia-smi: под постоянной нагрузкой RTX 4090 греется, а при перегреве карта сама снижает частоты, и задача считается дольше.
Сколько стоит аренда GPU-сервера в России: цены 2026
Цены на GPU-серверы у двух наших провайдеров зависят от видеокарты и площадки. На 21.10.2026 купить можно только у Timeweb Cloud — Tesla T4 на 16 ГБ за 16 800 ₽/мес при оплате за месяц; у AdminVPS GPU-тарифы «нет в наличии», ниже — его прайс:
- RTX 4090 (24 ГБ VRAM): у AdminVPS это тариф vGPU.v3-4090 — 28 669 ₽/мес при оплате за месяц на площадке в Исландии; тот же тариф в Нидерландах и Германии стоит 35 419 ₽/мес, тоже при оплате за месяц. Цены сверены со страницей провайдера 21 октября 2026 года. Подходит для запуска сжатых моделей примерно до 30B и генерации изображений.
- A100 40 ГБ: открытой цены нет ни у AdminVPS, ни у Timeweb Cloud — AdminVPS называет A100 в описании без готового тарифа, у Timeweb Cloud в предзаказе версия на 80 ГБ; стоимость считают по запросу, поэтому своего числа мы здесь не называем. Подойдёт для дообучения средних моделей методами LoRA и QLoRA; сжатая 70B (43 ГБ) в неё уже не помещается.
- A100 80 ГБ и H100: там же — по запросу; это карты для запуска больших моделей без сильного сжатия и — по нескольку в одном сервере — для полноценного обучения. Самое мощное, что можно взять по опубликованной цене, — vGPU.v3-4090d+ с двумя RTX 4090 и 128 ГБ RAM за 80 809 ₽/мес при оплате за месяц в Нидерландах: 48 ГБ видеопамяти на двоих, сжатая 70B (43 ГБ) туда помещается.
При постоянной нагрузке круглые сутки помесячный тариф удобнее тем, что сумма известна заранее. Для эпизодических задач — дообучение раз в неделю, пакетная генерация — выгоднее было бы почасовое списание, но у наших двух провайдеров его нет: AdminVPS размечает GPU помесячно, Timeweb Cloud на вопрос поддержке 21.10.2026 ответил так же. Для редких задач сравнивайте месяц аренды с оплатой облачного API за токены.
При сравнении цен учитывайте полную конфигурацию: объём RAM, количество CPU-ядер (влияет на предобработку данных), объём NVMe-хранилища (в библиотеке Ollama llama3.1:8b весит 4,9 ГБ, llama3.1:70b — 43 ГБ, llama3.1:405b — 243 ГБ) и включённый трафик. Дешёвый GPU VPS с 8 ГБ RAM для A100 — это ловушка: загрузка модели в VRAM обычно идёт через оперативную память.
Какую видеокарту брать под задачу: сводка
Для выбора правильной видеокарты определите свою основную задачу:
- Чат-боты и запуск моделей до 7B: хватит карты с 8–24 ГБ видеопамяти. Младшая ступень прайса AdminVPS — GTX 1080 Ti на 11 ГБ за 7 749 ₽/мес при оплате за месяц, в Исландии.
- Запуск моделей 13–34B: RTX 4090 (24 ГБ) со сжатием Q4 (qwen3:32b весит 20 ГБ) или A100 40 ГБ. RTX 4090 у AdminVPS — 28 669 ₽/мес при оплате за месяц, Исландия.
- Запуск моделей от 70B: сжатая 70B весит 43 ГБ, нужно 48 ГБ видеопамяти и больше — две RTX 4090 у AdminVPS за 80 809 ₽/мес при оплате за месяц или A100 80 ГБ, открытой цены на которую нет ни у одного из двух провайдеров — только по заявке.
- Stable Diffusion XL: минимум по Stability AI — 8 ГБ видеопамяти на карте уровня RTX 20-й серии; RTX 4090 на 24 ГБ даёт запас под ControlNet и крупные модели вроде Flux.
- Дообучение модели 7B методом QLoRA: RTX 4090 (24 ГБ) хватает с запасом — авторы метода укладывали в 48 ГБ модель на 65B; время зависит от размера датасета.
- Полное обучение и полное дообучение: несколько A100 или H100 в одном сервере — даже модель на 7B, по пропорции из работы о QLoRA, в одну карту на 80 ГБ не помещается. Время зависит от размера датасета и модели.
Если вы только начинаете и не уверены в требованиях — берите не топовую карту, а младшую из прайса. Переходить на RTX 4090 и старше стоит тогда, когда упрётесь в объём видеопамяти на своей задаче, — это видно сразу и не требует замеров.
Заключение
GPU-сервер с понятной ценой на 21.10.2026 можно взять у Timeweb Cloud: выделенный сервер с Tesla T4 — 16 800 ₽/мес при оплате за месяц. Линейка AdminVPS идёт от 7 749 ₽/мес за GTX 1080 Ti в Исландии до 80 809 ₽/мес за две RTX 4090 в Нидерландах, все цены при оплате за месяц, но в тот день корзина по ней отвечала «нет в наличии». Для запуска небольших моделей хватит младших карт, для серьёзного обучения нужна A100 или H100 — а их цену считают по заявке.
Из тех, кого мы сравниваем, GPU-серверы продают двое — Timeweb Cloud и AdminVPS, и почасовой аренды GPU нет ни у одного: только месяц. Карты уровня A100 и H100 у Timeweb Cloud открыты по предзаказу. Сравнить GPU-серверы можно в нашем каталоге.
GPU-серверы не дёшевы: Tesla T4 у Timeweb Cloud — 16 800 ₽/мес, RTX 4090 у AdminVPS — 28 669 ₽/мес в Исландии, обе цены при оплате за месяц. Для серьёзных ML-задач A100 и H100 дают профессиональный уровень с NVLink и большим объёмом VRAM — у Timeweb Cloud они открыты по предзаказу.
Начните с задачи и нужного объёма видеопамяти, возьмите младшую карту из прайса и переходите на старшую, когда упрётесь в память. Используйте наш каталог для сравнения GPU-тарифов у провайдеров, которых мы сравниваем.
Перед арендой GPU-сервера обязательно проверьте наличие предустановленных образов с CUDA и ML-фреймворками — это сэкономит время на настройку. Из двух наших провайдеров такой список есть у AdminVPS — PyTorch, TensorFlow и JupyterLab среди приложений для AI; в маркетплейсе Timeweb Cloud мы их не нашли.
Общие рекомендации по выбору VPS — в нашем каталоге VPS-провайдеров. Сравните AdminVPS и Timeweb Cloud — два провайдера GPU-серверов из тех, кого мы сравниваем. Для развёртывания ML-моделей через Docker: обзор Docker хостинга. Подробнее о GPU: NVIDIA Data Center GPUs.
Читайте также: Как выбрать VPS хостинг, Выделенные серверы, Каталог провайдеров.
Плюсы и минусы
Преимущества
- Карту не нужно покупать: Tesla T4 у Timeweb Cloud — 16 800 ₽/мес при оплате за месяц
- Конфигурацию можно сменить под задачу, не меняя своё железо
- Площадки в России, оплата в рублях
- Сервер берётся на месяц, а не покупается навсегда
Недостатки
- У AdminVPS 21.10.2026 все GPU-тарифы «нет в наличии»; цена у него зависит от страны: RTX 4090 в Исландии 28 669 ₽/мес, в Нидерландах и Германии 35 419 ₽/мес при оплате за месяц
- Почасовой аренды GPU нет ни у одного из двух: только месяц
- A100 и H100 по прайсу не купить ни у одного из двух: по запросу
- Своих замеров производительности карт мы не проводим
Реклама · АО «ТаймВэб»
Timeweb Cloud — GPU серверы для AI
Готовый выделенный сервер с Tesla T4 на 16 ГБ — 16 800 ₽/мес при оплате за месяц, только помесячно. Карты GeForce и серии A — по заявке с авансом от 5 000 ₽; A100, H100 и H200 — по предзаказу.
Реклама · ООО «Админвпс»
AdminVPS — GPU-серверы для ML
Открытый прайс: RTX A4000 на 16 ГБ в российском дата-центре — 10 959 ₽/мес при оплате за месяц; за рубежом есть и дешевле: GTX 1080 Ti в Исландии — 7 749 ₽/мес при оплате за месяц. Старшая сборка — две RTX 4090 за 80 809 ₽/мес при оплате за месяц. Базовая защита от DDoS и канал 1 Гбит/с.
Промокод EASYLINK — скидка 60 % на первый месяц при оплате за 1 месяц, кроме тарифов Lite.
Частые вопросы
Сколько стоит аренда GPU сервера для AI в России?
На 21.10.2026 купить GPU-сервер в российском дата-центре из тех, кого мы сравниваем, можно у Timeweb Cloud: выделенный сервер с Tesla T4 на 16 ГБ — 16 800 ₽/мес при оплате за месяц; почасовой и посуточной оплаты у GPU нет. У AdminVPS в России две карты: RTX A4000 на 16 ГБ за 10 959 ₽/мес и RTX A5000 на 24 ГБ за 17 709 ₽/мес, обе при оплате за месяц, но 21.10.2026 корзина по всем GPU-тарифам отвечала «нет в наличии». За рубежом у того же провайдера есть и дешевле — GTX 1080 Ti на 11 ГБ за 7 749 ₽/мес в Исландии, и дороже — RTX 4090 от 28 669 ₽/мес, тоже при оплате за месяц; если базы с персональными данными россиян по 152-ФЗ должны быть в России, по месту размещения они не подходят. Разбор с ценами по странам — на странице категории GPU-серверов.
Какой GPU нужен для запуска LLM модели?
Смотреть надо на объём видеопамяти: модель либо помещается в неё целиком, либо не запускается. Для вывода модели на 7 миллиардов параметров хватает 16 ГБ — это RTX A4000. Для дообучения модели 7B методом QLoRA 24 ГБ хватает с запасом: это RTX 3090, 4090 или A5000. Больше 24 ГБ по опубликованной цене даёт только сервер AdminVPS с двумя RTX 4090 — 80 809 ₽/мес при оплате за месяц; NVLink у RTX 4090 нет (так в спецификации NVIDIA), и модель делят между картами. Карты A100 и H100 AdminVPS называет в описании, но готовых тарифов с ними нет — такие конфигурации собираются по запросу, и цену придётся спрашивать отдельно.
Можно ли запустить Stable Diffusion на арендованном GPU-сервере?
Да. Для SDXL Stability AI при выпуске называла минимумом карту уровня RTX 20-й серии с 8 ГБ видеопамяти. В открытом прайсе AdminVPS под этот минимум подходит RTX A4000 на 16 ГБ — 10 959 ₽/мес при оплате за месяц, в российском дата-центре; GTX 1080 Ti за 7 749 ₽/мес — поколение GTX 10, раньше названной серии RTX 20. PyTorch и TensorFlow есть в списке приложений AdminVPS для AI; в маркетплейсе Timeweb Cloud готовых образов с ними мы не нашли.
Аренда GPU-сервера или облачный API — что выгоднее для нейросети?
Считать надо по своей нагрузке. GPU-сервер у наших двух провайдеров сдаётся только помесячно, так что сравнивать придётся месяц аренды — например, Tesla T4 у Timeweb Cloud за 16 800 ₽/мес при оплате за месяц — с оплатой API за токены за тот же месяц. Если карта нужна на несколько часов в неделю, платить всё равно придётся за месяц. Порог окупаемости мы не считали и чужой называть не будем.
Какие провайдеры предлагают GPU серверы в России?
Из тех, кого мы сравниваем, — двое, и устроены они по-разному. У AdminVPS цены в прайсе: в российских дата-центрах RTX A4000 на 16 ГБ за 10 959 ₽/мес при оплате за месяц и RTX A5000 на 24 ГБ за 17 709 ₽/мес; остальные карты линейки стоят за рубежом; 21.10.2026 корзина по всем GPU-тарифам AdminVPS отвечала «нет в наличии». У Timeweb Cloud выбор карт шире — Tesla T4, RTX 3090 и 4090, A5000 и A6000, а также A100, H100 и H200 по предзаказу, — на странице GPU цен нет, только заявка с авансом от 5 000 ₽, а среди выделенных серверов есть готовый с Tesla T4 на 16 ГБ за 16 800 ₽/мес при оплате за месяц. Почасовой оплаты у GPU-серверов нет ни у кого из двух. Отдельной страницей Timeweb Cloud продаёт серверы с RTX 5090 на 32 ГБ — тоже без цены, по заявке.
Какой сервер нужен для нейросети?
Смотреть надо на объём видеопамяти, а не на процессор: модель либо помещается в неё целиком, либо не запускается. В сжатом виде, в каком модели раздаёт Ollama, модель на 8 миллиардов параметров весит около 5 ГБ, на 14 миллиардов — 9,3 ГБ (qwen3:14b): обе помещаются в RTX A4000 на 16 ГБ за 10 959 ₽/мес у AdminVPS. В полной точности 16 бит модель на 8B весит уже 16 ГБ — это A5000 на 24 ГБ за 17 709 ₽/мес. Обе карты в российских дата-центрах, цены при оплате за месяц. Для обучения нужны A100 или H100, их открытой цены нет ни у одного из двух провайдеров — считают по заявке; сжатую модель на 70B (43 ГБ) можно запустить на сервере AdminVPS с двумя RTX 4090 за 80 809 ₽/мес при оплате за месяц. Если модель небольшая и квантизованная, сервер с видеокартой может не понадобиться вовсе: хватит обычного VPS с мощным процессором.
GPU серверы в каталоге
Каталог GPU серверовСтатья содержит партнёрские ссылки. Мы получаем комиссию при переходе, это не влияет на цену для вас и помогает развивать проект. Подробнее
Об авторе